Enjeu 1 : Pour devenir un assistant, l'IA doit étudier vos documents
Copilot et Gemini cherchent très bien un document précis. Mais sur les sujets métier, leurs réponses restent génériques. Pour qu'émergent de vrais usages, l'IA doit devenir un assistant, nourri des documents qui font foi dans l'entreprise.
Beaucoup d'organisations choisissent donc de brancher une IA sur leurs propres documents, opérée sur leur infrastructure ou chez un éditeur tiers. Quelle que soit l'option, elle a besoin d'un corpus trié, à jour et accessible. Aujourd'hui, ce travail de sélection est dévolu aux collaborateurs. C'est l'angle mort de la démarche.
Enjeu 2 : Moins de 2 % des documents ont une valeur de connaissance
SharePoint, OneDrive et Teams concentrent ce que l'entreprise écrit et décide. Mais l'essentiel de ce volume est du bruit : documents obsolètes, versions intermédiaires, doublons. Par exemple, chez Lecko, 3 852 documents ont été retenus sur 250 000 indexés.
< 2 % des documents ont une valeur de connaissance
Enjeu 3 : Sélectionner à la main, un travail sans fin
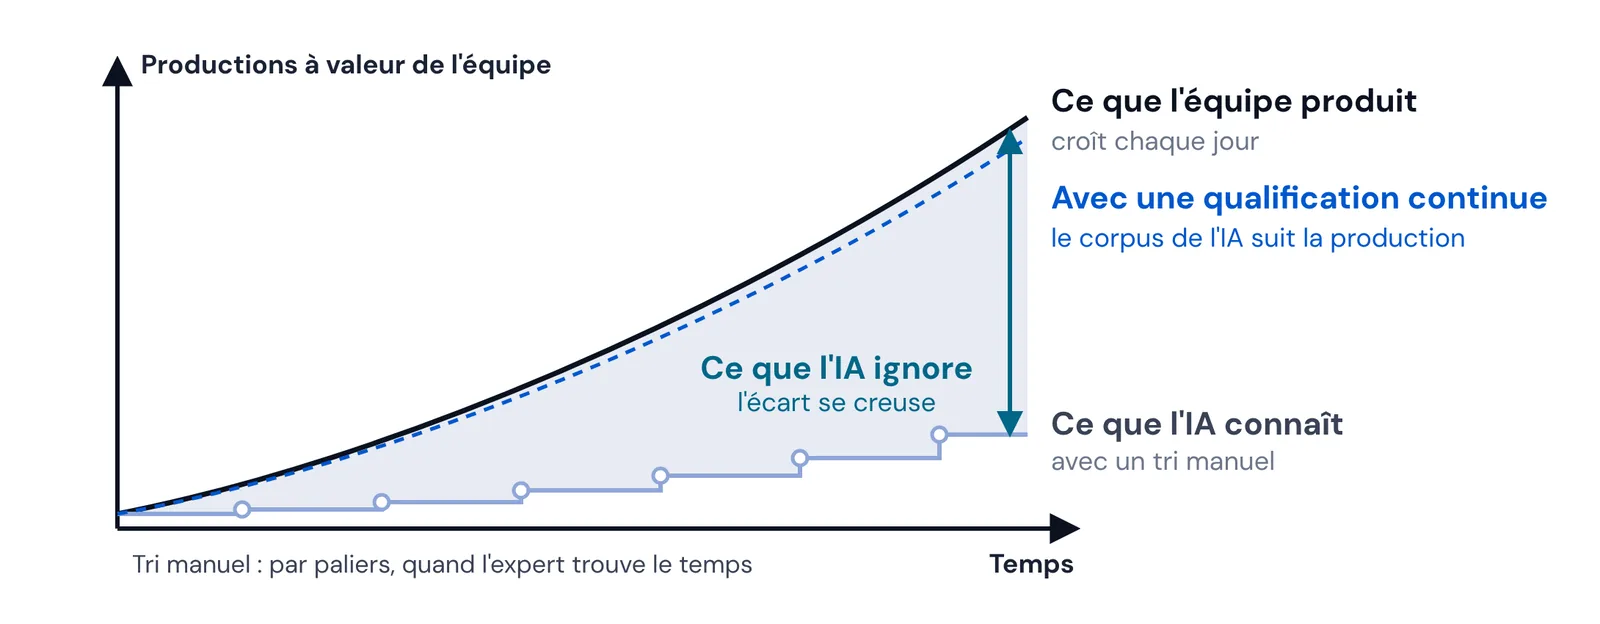
Pour rendre leurs agents pertinents, les entreprises demandent à leurs experts de choisir les documents à transmettre à l'IA. Les notebooks de Microsoft et Google reposent sur la même démarche. Mais chaque document produit doit à son tour être sélectionné : l'IA prend du retard sur ce que l'équipe produit.
La suite de l’analyse
Sept points, avec le support et les schémas à réutiliser chez vous.
- Deux modes d’accès de l’IA au patrimoine de l’entreprise
- Où opérer son IA
- Qualifier en amont, en continu
- Qualifier sans lire
- Les experts valident, l’assistant qualifie
- Une passerelle sécurisée vers l’IA de votre choix
- Ce que chacun y gagne
Le support de l’analyse (PowerPoint et PDF) et les schémas, réutilisables librement
Merci. Je viens de vous envoyer le lien vers la suite de l'analyse. Pensez à vérifier vos courriers indésirables si vous ne le voyez pas d'ici quelques minutes.
Questions fréquentes
Faut-il renoncer à Copilot ou à Gemini ?
Non. Gr33t ne remplace pas votre IA : il lui livre en continu les documents qui comptent, que ce soit Copilot, Gemini, un RAG sur mesure ou une IA d'un éditeur tiers.
Gr33t lit-il nos documents ?
Non. La qualification s'appuie sur les métadonnées, l'organisation des espaces et les schémas de nommage, sans lire le contenu. C'est aussi ce qui fait l'originalité de Gr33t : une qualification économique et sobre, qui consomme une fraction infime des tokens qu'exigerait la lecture de chaque document. Traitement dans votre tenant, certification CyberVadis.
L’autre moitié du sujet : Votre IA connaît-elle votre métier ?